超文本本来是为科学家发明的:1945 年,万尼瓦尔·布什设想用“联想轨迹”串起文献;1989 年,伯纳斯-李为 CERN 的物理学家提出了万维网。八十年过去,学术成果的基本单位却仍是一篇篇模仿纸张的论文。本文追溯这段历史,解释超文本为什么没能改变论文,并提出分层的作品与分形的网络:每一次策展都是一张问题网络。我们也讨论它的先例、它对机器读者的意义、它在网络中如何取信、策展人这一新角色,以及它的风险;而这组论题本身,就是一个示例。
一读者需要什么?#
一篇论文像一张照片。它把一项研究定格在某一刻:问题、方法、结果,构图讲究,边框清楚,可以装进期刊这本相册,被引用,被收藏。照片的长处是稳定,局限也是稳定:它只拍到快门按下时镜头对准的那一面,失败的尝试、放弃的方向、后来补上的证据,都不在画面里。这算不上缺陷,只是论文作为印刷时代知识的身体与生俱来的形状。
一个研究领域却像一座城市:街道在延伸,旧楼在翻修,有的路走不通了,有的新区还没有名字。开放学术索引 OpenAlex 收录的作品已超过 4.77 亿件1,而生成式 AI 又让写出一篇论文的成本骤降,照片只会越拍越多。面对这样一座城市,再多一张照片帮助不大。初来的人需要地图:从哪里进城,先去哪里,哪条街通向哪里,哪里正在施工;老住户也需要,因为城市变化的速度早已超过个人的记忆。学术出版却几乎只生产照片,画地图的活儿,要么留给教科书,要么留给读者自己。
本文要讨论的,就是怎样为知识画地图。主张可以浓缩成一句话:每一次学术策展都不是单篇论文,而是一张问题网络。它有清楚的起点;每个论题分层,先给一张能独立读完的论题页,讲清它在问什么,再给展开论证的深读,再往下是出处、数据与过程;论题之间用问题互相牵连,读者可以从任何一处进入。宣言把这称作为知识换一个身体,这里要讲清它的来历、理由和代价。为这件事准备的技术其实早就有了,而且本来就是为科学家准备的。
二超文本是为谁发明的?#
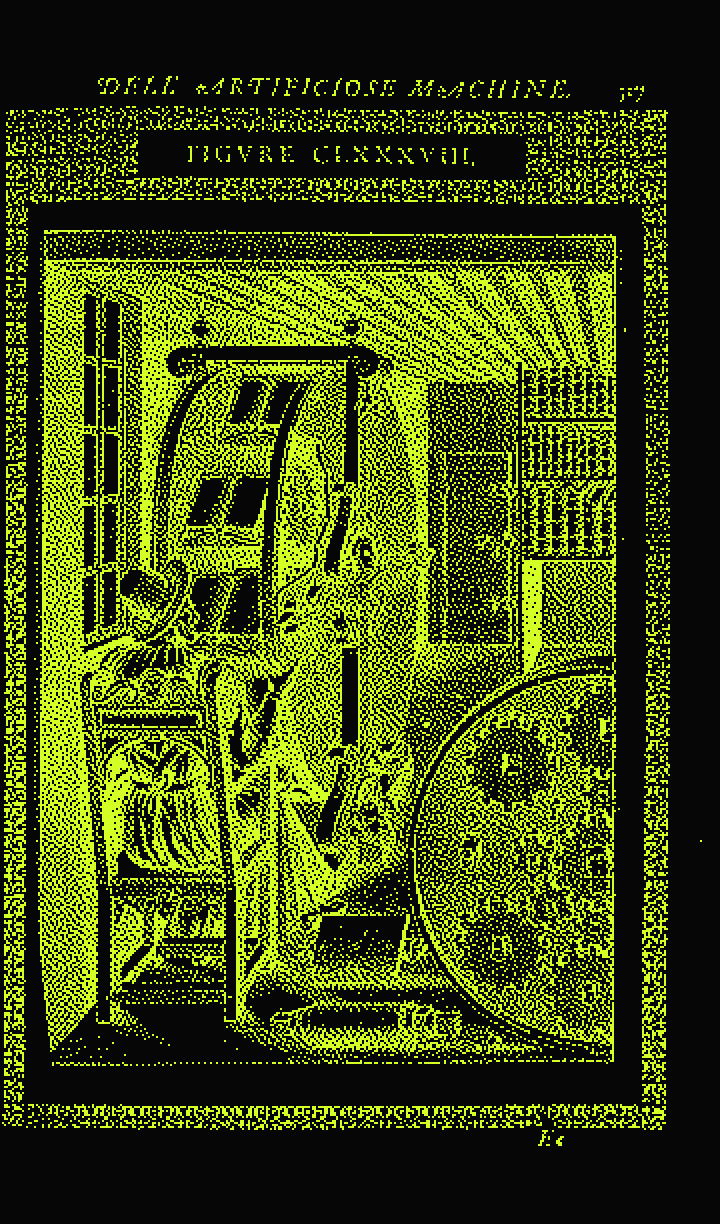
书太多、桌太小,是学者的老问题。1588 年,意大利工程师拉梅利在《各式精巧机械》里画过一台“书轮”:读者坐在轮前,转动轮子,就能在一摞摞摊开的书之间来回翻阅,既不用起身,也不用占一张大桌子2。
1945 年 7 月,《大西洋月刊》刊出万尼瓦尔·布什的《诚如所思》(As We May Think)。编者按介绍,作者作为美国科学研究与发展局局长,协调过约六千名顶尖科学家把科学用于战争3。战争将尽,布什想的是科学家接下来该做什么。他抱怨,人类经验的总和正以惊人的速度扩张,而我们穿过这座迷宫、找到一时要紧之物的办法,还和横帆船时代一样;孟德尔的遗传定律被世界遗忘了一代人,就因为他的论文没有送到少数能够理解并推进它的人手里。
他设想了一张叫 Memex 的书桌,个人的书籍、记录和通信都存在里面,可以飞快地调阅。但他最看重的是“把两项东西系在一起”:人的心智不按字母和分类工作,而是靠联想。Memex 的主人可以在材料的迷宫里建起一条自己兴趣的轨迹,插入评注,用支路连向别处,还可以把整条轨迹复制给朋友。布什预言,将会出现预先织好联想轨迹之网的新式百科全书,还会出现一种新职业,“开路人”(trail blazers),他们乐于在人类共同记录的巨量堆积中开辟有用的轨迹3。
这篇文章找到了它的读者。1945 年秋天,身在菲律宾莱特岛的恩格尔巴特,在丛林边一间红十字会图书馆里读到了它4。1968 年 12 月 9 日,他在旧金山的秋季联合计算机会议上,连线约 30 英里外斯坦福研究所的 NLS 系统,做了九十分钟的现场演示:鼠标、超文本链接、窗口、共享屏幕协作、视频会议,后来被称作“所有演示之母”5。更早一些,泰德·纳尔逊在 1965 年美国计算机协会的全国会议上公开使用了 hypertext(超文本)一词6;他 1960 年创立的 Xanadu 计划,追求不会断裂的双向链接、引而不抄的“嵌引”(transclusion)和完整的版本管理78。
让超文本走进千家万户的,却是一家物理实验室。1989 年 3 月,伯纳斯-李在欧洲核子研究中心(CERN)写下《信息管理:一个提议》。他说,那里的人员通常只待两年,信息不断流失,很多时候信息记录下来了,只是找不到;而 CERN 是几年后整个世界的缩影9。1991 年 8 月,他在互联网新闻组上公布了万维网软件;同年 12 月,美国第一台网络服务器在斯坦福直线加速器中心上线,为的是方便查询该中心图书馆的高能物理预印本数据库 SPIRES1011。CERN 的官方简史说,网络最初就是为满足各地大学和研究所的科学家自动共享信息的需要而构想和开发的10。
此后,1995 年沃德·坎宁安开设了第一个维基12,2001 年 1 月维基百科上线,到 2026 年刚满二十五岁13。人人可以留下轨迹,百科全书天生织着联想的网,布什的设想成了日常。回头看,超文本从一开始就是给研究者用的:布什写给战后的科学家,伯纳斯-李写给 CERN 的同事,美国第一个网站服务的是物理学预印本。它改变了几乎一切,唯独没怎么改变论文。
三超文本为什么没有改变论文?#
今天的论文当然都在网上,但点开一篇,多半仍是一份 PDF:分栏、页码、图表编号,一切照着纸张排好。纳尔逊 1999 年挖苦说,在屏幕上模仿纸张,就像拆掉波音 747 的翅膀,拿它当公共汽车开14。2011 年“超越 PDF”研讨会之后发表的 FORCE11 宣言也批评,学者交流研究,至今主要靠“在纸上有选择地涂布墨迹”,至多换成它的电子复制品15。数字化只换了纸张的经过另有专文,这里只问:一项为科学家发明的技术,为什么没有改掉科学家的文体?
最根本的原因在信用。学术信用绑在可引用、可计数的静态单位上:一篇论文有固定的作者、题目、刊名、卷期和页码,发表后不再改动,才能被准确引用,才能写进简历、交给评审。超文本的长处恰恰是流动,可以随时修改,边界模糊。一个不断生长的网页算几篇论文?引用它时引的是哪一版?自 1665 年《哲学汇刊》创刊以来,学术共同体把判断、奖励和记忆都建立在“篇”上,审稿、评价乃至撤稿都以篇为单位。载体从来不只是容器,它规定了什么才算一项成果,这正是媒介塑造知识的方式。超文本没有提供新的单位,只能被旧单位吸收,成了投递 PDF 的管道。这并不奇怪:人们总是习惯于用旧技术语境下的概念来衡量新技术,汽车被看作自动的马车,电报被看作更快的信件,印刷书被看作更高效的手抄本,网页被看作更高级的书页。只要整个环境还没有围绕新媒介重新安排,评价、奖励和记忆都还按“篇”来算,汽车就只是一辆不用马的马车,超文本也就只是一条更快的邮路16。
第二个原因是链接本身靠不住。2014 年,齐特林、莱西格等人发现,三份哈佛法学期刊里七成以上的网址已不能指向当初引用的内容,美国最高法院判决书中的网址约有一半如此17。同年,克莱因、范德桑佩尔等人分析了 1997–2012 年间 350 多万篇科技医学论文,发现每五篇就有一篇遭遇“参考文献腐烂”:链接失效或内容已变,读者再也回不到论文当时的网络语境;在含有网页引用的论文里,这个比例是十分之七,而这类论文正越来越多18。皮尤研究中心 2024 年的调查显示,2013 年存在的网页到 2023 年已有 38% 无法访问,54% 的维基百科条目在参考资料里至少有一个死链19。马丁·保罗·伊夫 2024 年检查了七百多万篇带 DOI 的期刊文章,约 28% 在主要的长期保存档案里找不到任何副本20。
第三个原因是版本。纸本印出来就不会变,网上的东西随时可改,你引用的那句话明天可能已经不在。纳尔逊说,HTML 恰恰是 Xanadu 想要阻止的东西:链接不断断裂,只能单向指出,引文追不回出处,没有版本管理14。出版界的办法是把流动重新冻结,2008 年的一份行业建议把期刊文章分成作者原稿、录用稿、“记录版本”等七个阶段21。网络被学术界接受了,却被接受成了纸张的快递。还有一层原因在网络自己的走向上:早期的万维网靠个人主页和博客搭起来,天然去中心化,精英的知识可以沉淀;Web2 把工业化生产和流量逻辑引进网络,所有信息扁平化流动,自印刷术以来并存的两个层面,速朽的大众文化和沉淀的精英知识,被上下扯平,中文互联网走得更极端,个人网站几乎绝迹,只能按大社交平台的逻辑来,精英信息得以沉淀的空间被打没了。学者的主页和博客本来最像布什那条“轨迹”,它们的凋零让论文更没有对手。要让超文本真正改变学术作品,就得同时回答信用、单位、版本和存档这几个问题,也得把沉淀的空间重新建起来。
四一件作品可以有几层?#
回答的第一步,是把“一篇”拆成“一件”。宣言主张,同一项研究应当同时有七层:兼容期刊的核心论证,能点开数据、代码与实验记录的证据追溯,保留失败路径与版本差异的过程记录,由视频、交互模型和概念地图组成的多模态讲解,公开伦理、经费与 AI 使用的治理透明,供机器读取的 AI 接口,以及接纳批评、复现与分叉的共创演化。七层对应不同的入口:公众从视频进来,初学者从概念地图进来,同行从论文进来,复现者从数据进来,监督者从经费与伦理记录进来,机器从接口进来。
这并非凭空设想。2009 年,欧洲 DRIVER II 项目的文集提出“增强出版物”:出版物与相关对象一直被分开处理,彼此的联系很难找到,出版物应当主动提供这些链接22。2011 年的 FORCE11 宣言建议重新思考以论文作为知识交换的标准“通货”,提出“研究对象”:一个装着论文及相关数据集、工作流和软件的容器15。2013 年,贝克霍费尔等人主张把研究对象当作共享与出版的“一等公民”23;2016 年的 FAIR 原则要求研究数据可发现、可获取、可互操作、可复用,并说这些原则也适用于产生数据的算法、工具和工作流24。这些都属于开放科学的工具箱。
七层的新意不在某一层,而在于把它们都当作同一件作品的侧面,不再是论文的附件。旧体制里,数据是“补充材料”,代码“可应要求提供”,讲解算“科普”,失败的尝试干脆不写,它们在信用上都低论文一等。陶哲轩在 2026 年国际数学家大会讲演的基础上写道,作者讲述自己的洞见、走过的弯路和做题时的故事,能实实在在地帮助共同体消化一个结果25,这正是过程记录层要保存的东西。
讲解层同样需要正名。陶哲轩在同一篇文章的附录里列举了几种新的基础设施,其中有一份经过同行评议、专门发表研究讲座视频的数学期刊《数学话语》(Mathematical Discourse)25:讲解也可以被评审,被引用,被计入成果。七层要求的不是把一切摊平,而是各安其位:每一层都有自己的读者、质量标准和署名,谁拍了讲解视频、谁整理了数据、谁复现了结果,都写在明处。一件作品由此不再是一张照片,而像一栋有好几个入口的房子。
五怎样让每个入口都是起点?#
第二步,是把“一件”连成“一网”。分形是几何里的说法:局部与整体相似,放大一段海岸线,看到的仍是曲折的海岸线。宣言是一个起点,它的每一屏都留着几个追问,点开就进入某个延伸论题的论题页;论题页又是一个起点,可以读完就走,也可以往下潜到深读;深读的论断再链向出处、证据与过程,也牵着别的论题。每一层都有完整的开头、论证和结论,又都指向更深的一层。在任何尺度上,读者看到的都是同一种结构:一个起点,几条路;网络里的每个节点,也都可能成为另一位读者的起点。“分形”这个词我讲技术通史时用过:大环境与小环境之间呈现着自相似的结构,不同尺度下的技术环境往往结构相似26。但分层不是扁平化,去中心化也不是扁平化,它的好处恰恰是让自下而上形成的层次更丰富;所以我说过,我们需要城墙,也需要大门,门上还需要门槛27:论题页是大门,深读是门槛,出处、数据与过程是城内的街巷,进得越深,要求越高。
分层阅读并不新鲜。报纸的倒金字塔把最重要的事实放进导语;纳尔逊设想过一种“伸缩文本”(stretchtext),读者想知道更多时,文字就在原处展开细节28。今天的网页做到这一点毫不费力,难的是写作:同一个论证要写出几个尺度,每个尺度都不失真。论题页不是目录,也不是摘要的扩写,而是一页能独立成立、读来有趣的短文;深读也不是论题页的注水,而是把被压缩掉的证据、限定和反例放回去;一部作品的意义恰恰蕴含在它不可压缩的部分,论题页能替读者省时间,省不掉的是这一部分29。链接怎么写也有讲究。“详见某节”式的链接是目录的思维;我们更愿意用问题来牵线:一屏讲完,留下一个追问,想接着问下去的人,就被带到回答这个问题的地方。问题比关键词更诚实,它告诉读者为什么要走这一步。
分形结构还意味着,策展的单位从一篇变成一组。一张问题网络由若干互相牵连的论题构成,每个论题有自己的问题,合起来回答一个更大的问题。它像期刊的专刊,但专刊里的文章很少真正对话;也像维基百科,但维基百科追求中立的汇总,问题网络允许作者有立场、有署名。一个概念只在一处讲透,别处用一个问题指过去;一处修订,处处可见。网络还会长大:新作品加入,旧节点被批评、被替换,边界随研究推进而移动。值得评价的也就不只是一篇写得好不好,还有一组作品是否把一个问题讲透。这也许就是下一种身体的样子。
它还要求把读者的路径当回事。在布什那里,最珍贵的不是文献本身,而是穿过文献留下的轨迹;他说,大师留给弟子的遗产,不只是他对世界记录的增补,还有搭建这些增补的整副脚手架3。同一个网络,初学者可能从讲解走到定义,同行可能从论断直奔数据,批评者专找反例和失败记录;每条路径都是对这组作品的一种解释。路径本身也可以被策展:一位老师可以为初学者铺一条导览路线,一位批评者可以留下一条专挑毛病的路线。好的平台应当允许读者保存和分享自己的路径,让“怎么读”也成为可以交流的知识。
六有没有人已经这样做了?#
这种形态已有不少先例。2011 年 3 月,布雷特·维克托发表《可探索的解释》,提出“反应式文档”:读者可以改动作者的假设,立刻看到后果;他希望文字不再只是被消费的信息,而是思考的环境30。2016 年 9 月起,一批机器学习研究者在 Distill 上发表交互式文章,2017 年 3 月它正式以期刊面目亮相3132。它的两位编辑奥拉与卡特在《研究债务》里说,把研究讲清楚的“研究提炼者”,应当像理论家、实验家一样被视为研究共同体不可缺少的角色,而他们的工作至今不被当作真正的研究贡献33。可是 2021 年 7 月,Distill 宣布休刊:早期一些文章,编辑们在图表和文字上投入了五十多个小时,全是本职之外的志愿劳动;他们认为,大多数文章的未来可能是自行发布34。
另一条线是“活”的综述。1998 年,德国马普引力物理研究所创办《相对论活综述》,由作者定期更新文章35。创办人舒茨 2013 年说,它在某些方面可以算“科学界的维基百科”,但作者经过遴选、文章经过严格评审,标准更高,因为它要充当可靠的参考来源36。小修以年度快速更新的方式进行,沿用原编号;大改要重新送审,获得新编号;旧版本仍可从文章历史里查到37。2014 年,医学界提出“活的系统综述”,随新证据持续更新38。活综述说明,可更新与可引用并不矛盾,只要版本管得清楚。
第三条线是可执行的论文。LIGO 首次探测到引力波之后,其开放数据中心提供了分析 GW150914 信号的教程,读者可以用 IPython 笔记本亲手做一遍滤波和频谱分析39。2018 年,詹姆斯·萨默斯在《大西洋月刊》发文,题为《科学论文已经过时了》,把希望寄托于 Mathematica 与 Jupyter 这类计算笔记本40。2020 年 8 月,eLife 推出“可执行研究文章”,读者可以在浏览器里检查、修改并重新运行论文中的代码41;美国地球物理联合会则在斯隆基金会资助下开展“Notebooks Now!”项目,想让计算笔记本成为学术出版中的首要研究对象42。
第四条线把论文拆细,再连成图。2010 年,格罗斯等人提出“纳米出版物”,把一条核心科学陈述连同语境,当作可以单独发现、连接和策展的单位43。2022 年 1 月上线的 OpenAlex 接替了微软学术图谱,把 4.77 亿件作品与作者、机构和资助者连成一张开放的图1;德国国家科学技术图书馆主持的开放研究知识图谱(ORKG),则尝试用机器可读的方式描述论文的研究贡献44。
走得最远的是数学。2023 年 11 月,陶哲轩等人在 Lean 里形式化多项式 Freiman–Ruzsa 猜想的证明,用帕特里克·马索开发的“蓝图”工具把人读的证明与代码连起来,依赖图上绿色表示已完成形式化,蓝色表示可以动手45。2024 年 9 月,他发起方程理论项目,在 GitHub 上向所有人征集 Lean 证明46;2025 年 4 月 14 日,项目确定了 4694 条原群等式定律之间全部 22,028,942 条蕴含关系,人写的证明与自动证明都经 Lean 检验47。一项成果以一张人人可点、处处可验的依赖网呈现,某种意义上也是公民科学在数学里的新形态。关于数学界如何回应 AI,另有专文讨论;这里只想指出,分形策展在数学里已有雏形。
七作品要不要对机器友好?#
分形网络的读者不只是人。维基媒体基金会 2025 年 4 月报告,在最耗资源的流量里,至少 65% 来自机器人,而机器人只占页面浏览量的约 35%48;同年 10 月,基金会又说维基百科的人类浏览量比上一年下降约 8%,原因之一是搜索引擎直接用生成式 AI 给出答案49。Cloudflare 的数据显示,2025 年 7 月,Anthropic 的爬虫每抓取约 3.8 万个页面,才给网站带回一次访问50。在科研里,名为 Kosmos 的“AI 科学家”一次运行平均要读约 1500 篇论文51。一项研究最勤奋的读者,很可能已经是机器。
对机器友好,要先说清“这是什么”。2011 年 6 月,谷歌、必应和雅虎联合推出 schema.org 词表,让网页用统一的结构化数据标明自己是一篇学术文章、一个数据集还是一个人,这些数据可以用 JSON-LD 写进网页52;谷歌学术也要求用 `citation_title` 之类的元标签写明题名、作者和日期,并且每篇文章单独成页53。这些规矩看似琐碎,却决定了一件作品能否被机器找到、认出和正确引用。
机器还需要一份干净的文本。2024 年 9 月,杰里米·霍华德提议在网站根目录放一份 Markdown 格式的 llms.txt,并为网页提供 Markdown 版本54。这项提议的效果仍有争议:谷歌的约翰·穆勒 2025 年说,据他所知没有哪家 AI 服务表示在用它55;Common Crawl 在 2026 年 7 月的抓取中找到约 58 万份 llms.txt,只有一半左右结构完整56。RenaSci 几样都做:作品页内嵌 schema.org 数据,作品地址加上 `?format=md` 即返回 Markdown,根目录有 llms.txt,作品库开放 REST 接口,并声明 CC BY 4.0 许可57。
更要紧的,是让机器分清主张、证据与推测。论文里“我们证明了”“数据显示”“我们猜测”排在同一种字体里,人靠经验分辨,机器却容易把推测当成结论。纳米出版物把陈述与语境分开表示43;形式化数学的依赖图把已证与待证标成不同颜色45。Kosmos 为报告里的每条陈述标注代码或原始文献,可以追溯,也就可以核查:独立科学家发现其中 79.4% 的陈述准确51。分层作品应当给出结构化的主张清单,每条链向支撑它的数据、代码和段落;附上可执行的代码与开放接口,机器就不只能读,还能复算。这不是讨好机器,而是逼作者把论证结构讲清楚,对人同样有益。
八链接越多,谁来担保?#
链接越多,可信越成问题。在科学史上,可信从来不是文本自带的。夏平与谢弗研究波义耳的空气泵实验时指出,实验事实靠物质、文字与社会三种技术共同生产,详尽的实验报告让不在场的读者也能“虚拟见证”58。论文就是这种见证技术的后代。进入网络之后,见证技术需要换代,宣言为此定下了新的标准:证据可以点开,成果有人讲得清,AI 写在明处。落到技术上,至少有四件事:标识与存档,精确到段落和版本的引用,变更记录,AI 参与的自动记录。
DOI 给作品一个不随网址变化的名字,但名字不等于副本,前面说过,约 28% 带 DOI 的文章在主要档案里找不到副本20。CERN 与 OpenAIRE 在 2013 年推出的 Zenodo 接受任何形式的研究成果,并区分代表全部版本的 DOI 与代表某一版本的 DOI5960,2026 年 6 月的《莱顿宣言》就在上面存档61。由法国国家信息与自动化研究所发起、与联合国教科文组织合作的 Software Heritage 以保存所有公开的源代码为使命62,截至 2026 年 9 月底已存档约 300 亿个源文件63;互联网档案馆的时光机在 2025 年 10 月存档的网页突破一万亿个64。针对链接腐烂,范德桑佩尔等人提出 Memento 协议,可以按日期取回网页的旧状态65;“稳健链接”则建议每个链接同时写上原网址、存档快照和链接日期66。
引用的粒度,数学里已有榜样。2005 年萌生、2008 年动笔、由德容维护的代数叠计划(Stacks project)是一部不断生长的开源参考书,至今有两万一千多个“标签”:每条结果一个四位的永久编号,不论结果挪到哪一章,标签都指向它;即使某条结果被发现有错而删去,标签也会保留,并说明它为何消失676869。2013 年起,网站还能为每条结果画出依赖图70。Software Heritage 的标识符可以精确到某个源文件的某几行71。问题网络也应如此:每段有稳定的锚点,每版有冻结的快照,读者今天点开的链接,十年后仍落在同一句话上。引注的本意不是装点门面,而是方便同行求证和批评,标明自己在公共学术空间里的位置;可信也从来不来自某一句话,而来自一层层文本的阵列,援引的文本越多、越厚,结论就越可靠,确定性是关系网中稳固的节点72。锚点与快照,无非是让这张网在网络时代也能被一步步追下去。
变更与披露同样要留痕。活综述的更新规则已经说明,修订可以和引用共存37。《自然》在 2023 年 1 月规定,大语言模型不能列为作者,使用者应在方法或致谢中说明73;《莱顿宣言》同样要求披露工具的使用,把署名留给人61;各学科的做法见期刊、资助机构与学会的规则。陶哲轩那篇大会讲演稿的末尾就写明,文献检索、生成图表、补全文字和把幻灯片转成论文,都用了 AI25。但披露不该是一段事后补写、像忏悔一样的声明,而是过程的自动产物:用了哪个模型、查了哪些来源、改了哪一段,本来就记录在研究过程里,平台把它显示出来就是了。AI 越深地参与检索、写作和计算,这份记录就越是可信的一部分。
最强的见证是形式化验证。2020 年 12 月,彼得·舒尔策公开征求有人用 Lean 验证他的一个定理:他为这个证明着迷了大半个 2019 年,却觉得没有别人敢细看,自己仍有些许疑虑,还承认偶尔能用错误的论证说服别人74;一年半后,“液态张量实验”完成了验证75。陶哲轩说,形式化验证过的证明,其正确性不再依赖作者的声誉或勤勉;但“一个没有人能够恰当解释的证明,即使经过形式化验证,也应被视为不完整”25。机器能见证“对”,还不能见证“懂”。
九为知识画地图,算不算学问?#
编排这样的网络,需要一个新的学术角色:策展人。英语的 curator 来自拉丁语 curare,意为照料,1660 年代才有了博物馆管理者的意思76。博物馆的策展人从成千上万件藏品里挑出几十件,排成一条参观路线,为展品写说明,为展览写导言,撤展之后还要修复、编目、照料。学术策展人做的几乎一样:选择哪些作品进入网络,决定起点和路径,为每个论题写论题页、提出追问,并在之后的年月里修订、修补死链、回应批评。
这个角色早有人预言:布什的“开路人”3,奥拉和卡特的“研究提炼者”。后两位还说,提炼和讲解需要的创造力与深入理解,并不比做出新研究少33。学术界也一直依赖这类工作:综述、教科书、专刊的客座编辑、维基百科的专题维护者,都在选择、编排、说明和维护。2015 年,高尔斯宣布创办 Discrete Analysis:论文仍放在 arXiv 上,期刊组织评审,为录用的论文配上编辑撰写的介绍和 DOI77。这种“覆盖期刊”本身就是一层策展。策展人也是拆分角色之后出现的一个新位置。
问题是这类工作很少计入信用。一篇综述也许被大量引用,在许多评价体系里却不如一篇“原创”论文;维护数据库、标签体系和依赖图,更难写进简历。好在已有松动:2022 年成为美国国家标准的 CRediT 贡献者角色分类列出 14 种角色,其中就有“数据策展”和“可视化”78。宣言的十四条主张里有一条说,声誉是成就,不是计数;策展就该是其中一种成就:你编排的网络被多少人走通,你写的导读帮多少初学者入了门,你维护的节点多少年没有死链。
AI 会让策展变得便宜,也可能让它变得危险。它可以通览一切书籍,读得比任何人都多、都快,能综述、能画依赖图、能查死链,起草论题页也未必比人差;但选书的责任仍然在人79。策展说到底是选书和鉴赏,学者的位置更像品酒师:机器化验能更精确地揭示酒的成分,却取代不了品酒师,因为只有人才爱喝酒。机器负责智慧,人类负责爱80。选择什么进入网络、什么被排除,把哪条路设为起点,哪个反例必须放在显眼处,这些判断决定了读者会看到怎样的知识图景。如果把选择也交给按点击率优化的算法,策展就会退化成推荐,网络也会越来越像一面只映出读者偏好的镜子。选择和判断属于人,也应当由署名的人负责。
十网络会让人迷路吗?#
分形策展有真实的风险。第一是迷宫:链接给读者自由,也给读者迷路的机会,点过五六次之后,读者常常忘了为什么出发,也不知道还剩多少没读。第二是碎片化:论证拆成节点,每个节点都能单独转发,也就能被断章取义;纳米出版物和知识图谱让陈述更便于机器处理,也让它们更容易脱离限定和反例。论文的线性叙述自有道理,它强迫作者把前提、推理和结论放在同一条路上,也强迫读者走完。但我不打算为印刷时代唱挽歌:就像短视频之于印刷书,网络时代的叙事形态一定是更碎片化、更情绪化的,这就是时代大势;要做的不是把读者赶回线性长文,而是在碎片之间重新建起层次。
第三是注意力。赫伯特·西蒙 1971 年说,信息消耗的是接收者的注意力,因此信息的丰富造成注意力的贫乏81。层层可点的多模态作品争夺的是同一份注意力,平台一旦按点击和停留时间排序,策展就会沦为标题和短视频的竞赛,把计量化的老病换个形式重演。人的注意力“刷新”有极限,而生产的加速没有极限,刷新过快排斥的正是沉浸、咀嚼和回味82;但沉浸与游离是两种偏向,人都需要,御宅族与低头族的差别不在内容而在形式83,一个好的网络既要让人能在节点之间游走,也要有让人驻足的房间。陶哲轩还提醒,讲解也会被过度优化:被 AI 打磨得太顺滑的证明,会磨掉作者在难处留下的“摩擦”,成了容易读、却难从中学到东西的文字25。论题页尤其要警惕这一点。AI 读者也有它的风险:它可能只读论题页就下结论,把一个节点当成整个网络。
第四是腐烂与维护。可执行的论文同样会腐烂:2019 年的一项研究从 GitHub 上收集了 140 万个 Jupyter 笔记本,在尝试执行的 86 万多个里,只有 24.11% 能无错运行,只有 4.03% 得出与原来相同的结果84。Distill 的休刊说明,精心编排的作品需要持续的人力34。纳尔逊 1999 年就形容网络是“一团不断破裂的泡沫、不断变换的橱窗”14。第五是“永远未完成”:可以随时修改的作品,也可以永不定稿。Xanadu 从 1960 年做起,1995 年就被《连线》杂志称作计算机工业史上历时最久的“雾件”8。
对策大多是把旧体制里有用的纪律搬进网络。要有清楚的起点:每张问题网络有一个入口页,说明它回答什么问题、从哪里读起。要有层级:每个论题先给一页能独立读完的论题页,不点任何链接也能拿到完整的论点。要有地图:显示所有节点与主要路径,标明读者此刻的位置。要冻结版本:定期发布带编号的版本并存档,引用指向冻结的版本。还要有维护承诺:谁负责,维护到何时,停止维护时如何存档。未完成可以是一种诚实,但每个阶段都该有一个可以引用、可以批评的完成版本。
十一这张网自己做到了吗?#
读到这里,读者也许已经注意到,这篇文章本身就是它所描述之物的一部分。这组论题有八个节点。起点是宣言科学的复兴:科学一直在进步,要复兴的不是古人的知识,而是求知的乐趣;为此,要为知识换一个身体。七个延伸论题各自追问一个方向:知识的身体问论文是不是知识唯一的身体,洪水与堤坝问论文为什么越来越多、越来越难读,科学的观众席问公众为什么该回到科学里,为了好奇问科研还能不能好玩,AI 进入实验室问 AI 进了各个学科之后真正的瓶颈在哪里,学术流水线问科研成了一份工作之后求知的热情去了哪里,本文则问学术作品如果不再是一篇论文,该长成什么样。
每个节点都有两层,外加一层出处:一张可以滚动读完的论题页,一篇带注释的深读,以及深读背后的参考资料。论题页的每一屏都以一个问题开头,结尾留下几个追问;点一个追问,就走进回答它的那个论题。宣言每一屏的追问通向延伸论题,每个延伸论题也都有追问通回宣言。深读之间在具体论点处互相链接,脚注在网页上会变成通往来源的链接。读者可以从任何一个问题开始,走到哪里,哪里就是新的起点。
地图上还画出了几条问题的路线,读者可以照着走,也可以不理。关心“复兴什么”的读者,可以从宣言讲求知之乐的一屏出发,走到惊奇与闲暇,再到书籍,看印刷怎样让那一次复兴再没衰落;关心“什么异化了科学”的读者,可以从流水线走到计量化,再到被挤掉的乐趣;关心“危机怎样变成转机”的读者,可以从瓶颈的迁移走到公民科学的复兴;只想知道接下来要做什么的读者,可以直接翻到宣言里讲我们要做什么的那一节。每一条路线都是一种读法,也是一种解释。
它也会不断修订。宣言已经从 v0.1 改到 v0.6,问题网络这一版(v0.8)又围绕“科学的复兴”把它整体重写,每一版都写明谁提出方向、AI 参与了什么。这组论题会沿用同样的做法:冻结版本,公开变更;它的起草也有 AI 参与,版本记录会写清楚谁做了什么。说得具体些,我近来写书的流程是:先让一家 AI 生成初稿,我自己动手改一章,示范我的取向,再让另一家 AI 据此继续修改增补,然后我自己再增补修改,最后交给 AI 校对润色85。我也试过另一种合作:让 AI 扮演记者来采访我,由它像记者那样截选、润色后发表,我把这叫“AI 记者体”,因为让 AI 以我的名义直接写作,总觉得不对味,我毕竟是以写作本身为乐趣的。这组论题当然也有上一节列出的全部风险,而且它们自己也没有逃出前面说的旧标准:这些深读仍然分节、引注、定稿,仍以印刷时代关于“文章”的标准约束着自己,最终还是从印刷书的角度被衡量72。把它做出来,正是为了在真实的读者面前检验这些风险。一张问题网络是否成立,不看链接有多密,而看读者顺着问题走完一条路之后,是否比读一篇论文懂得更多。
※出处
- 1
OurResearch:“About us”,OpenAlex Help Center,2026 年 9 月 30 日访问(收录逾 4.77 亿件学术作品;2022 年 1 月 3 日上线测试版;接替 Microsoft Academic Graph;数据以 CC0 发布)。 help.openalex.org/hc/en-us/articles/24396686889751-About-us ↩↩2
- 2
Agostino Ramelli: Le diverse et artificiose machine del capitano Agostino Ramelli, Paris, 1588, plate 188(书轮)。Science History Institute 数字馆藏。 digital.sciencehistory.org/works/w6634396g ↩
- 3
Vannevar Bush:“As We May Think”,The Atlantic Monthly,1945 年 7 月。 theatlantic.com/magazine/archive/1945/07/as-we-may-think/303881/ (W3C 存档全文:w3.org/History/1945/vbush/vbush-all.shtml ) ↩↩2↩3↩4
- 4
Douglas C. Engelbart:Letter to Vannevar Bush,1962 年 5 月 24 日(斯坦福大学课程资料转录)。 web.stanford.edu/class/history34q/readings/Engelbart/Engelbar… ↩
- 5
Doug Engelbart Institute:1968 年 12 月 9 日演示(“The Mother of All Demos”)介绍页,2026 年访问;演示的内容另见计算机历史博物馆:“Douglas C. Engelbart – 2005 Fellow”,与 SRI International:“1968 ‘Mother of All Demos’ Forecasted Much of the Technology We Use Every Day”,2012 年 12 月 10 日。 dougengelbart.org/content/view/209/ ;computerhistory.org/profile/doug-engelbart/ ;sri.com/press/blog-archive/1968-mother-of-all-demos-forecaste… ↩
- 6
T. H. Nelson:“Complex Information Processing: A File Structure for the Complex, the Changing and the Indeterminate”,Proceedings of the 1965 20th ACM National Conference,pp. 84–100,1965。 doi.org/10.1145/800197.806036 ↩
- 7
Project Xanadu:官方主页(“Founded 1960 · The Original Hypertext Project”),2026 年访问。 xanadu.com/ ↩
- 8
Gary Wolf:“The Curse of Xanadu”,Wired 3.06,1995 年 6 月。 wired.com/1995/06/xanadu/ ↩↩2
- 9
Tim Berners-Lee:“Information Management: A Proposal”,CERN,1989 年 3 月(1990 年 5 月重新分发)。 w3.org/History/1989/proposal.html ↩
- 10
CERN:“A short history of the Web”,2026 年访问。 home.cern/science/computing/birth-web/short-history-web ↩↩2
- 11
SLAC Archives, History & Records Office:“WWW@SLAC Exhibit”,2026 年访问(1991 年 12 月 12 日上线,服务 SPIRES-HEP 预印本数据库)。 ahro.slac.stanford.edu/wwwslac-exhibit ↩
- 12
Wikipedia:“WikiWikiWeb”(最后手段;条目记 1995 年 3 月 25 日由 Ward Cunningham 开设,配合 Portland Pattern Repository),2026 年访问。 en.wikipedia.org/wiki/WikiWikiWeb ↩
- 13
The Signpost:“News and notes”,2026 年 1 月 15 日(“January 15, 2026, marks the 25th anniversary of the 2001 inception of Wikipedia”)。 signpost.news/2026-01-15/News_and_notes ↩
- 14
Ted Nelson:“Ted’s ComParadigm in OneLiners”,1999 年 1 月 29 日。 xanadu.com.au/ted/TN/WRITINGS/TCOMPARADIGM/tedCompOneLiners.html ↩↩2↩3
- 15
FORCE11:“FORCE11 Manifesto: Improving Future Research Communication and e-Scholarship”,2011 年 10 月 28 日。 force11.org/info/force11-manifesto/ ↩↩2
- 16
胡翌霖:《科学文化史话》,北京大学出版社,2014。 ↩
- 17
Jonathan Zittrain, Kendra Albert & Lawrence Lessig:“Perma: Scoping and Addressing the Problem of Link and Reference Rot in Legal Citations”,Harvard Law Review Forum 127: 176,2014。 harvardlawreview.org/forum/vol-127/perma-scoping-and-addressi… ↩
- 18
Martin Klein, Herbert Van de Sompel, Robert Sanderson et al.:“Scholarly Context Not Found: One in Five Articles Suffers from Reference Rot”,PLOS ONE 9(12): e115253,2014。 doi.org/10.1371/journal.pone.0115253 ↩
- 19
Athena Chapekis, Samuel Bestvater, Emma Remy & Gonzalo Rivero:“When Online Content Disappears”,Pew Research Center,2024 年 5 月 17 日。 pewresearch.org/data-labs/2024/05/17/when-online-content-disa… ↩
- 20
Martin Paul Eve:“Digital Scholarly Journals Are Poorly Preserved: A Study of 7 Million Articles”,Journal of Librarianship and Scholarly Communication,2024;数字据作者在 LSE Impact Blog 的介绍(2024 年 2 月 13 日)。 blogs.lse.ac.uk/impactofsocialsciences/2024/02/13/the-digital… ↩↩2
- 21
NISO/ALPSP JAV Technical Working Group:“Journal Article Versions (JAV)”,NISO RP-8-2008,2008。 niso.org/publications/niso-rp-8-2008-jav ↩
- 22
Marjan Vernooy-Gerritsen(编):《Enhanced Publications: Linking Publications and Research Data in Digital Repositories》,Amsterdam University Press,2009。 library.oapen.org/handle/20.500.12657/99940 ↩
- 23
Sean Bechhofer et al.:“Why linked data is not enough for scientists”,Future Generation Computer Systems 29(2): 599–611,2013。 doi.org/10.1016/j.future.2011.08.004 ↩
- 24
Mark D. Wilkinson et al.:“The FAIR Guiding Principles for scientific data management and stewardship”,Scientific Data 3: 160018,2016。 nature.com/articles/sdata201618 ↩
- 25
Terence Tao:“Mathematics in the age of AI”,arXiv:2608.16753,2026(据 2026 年 7 月国际数学家大会公开讲演整理)。 arxiv.org/abs/2608.16753 ↩↩2↩3↩4↩5
- 26
胡翌霖:《技术通史论纲》,随轩(yilinhut.net),2014 年 11 月 21 日。 yilinhut.net/2014/11/21/5175.html ↩
- 27
胡翌霖:《重建门槛——Web3确实是一种“圈地自high”的倒退,但未必是坏事》,随轩(yilinhut.net),2022 年 1 月 30 日。 yilinhut.net/2022/01/30/8437.html ↩
- 28
Wikipedia:“Stretchtext”(最后手段;条目称该词由 Ted Nelson 在 1970 年发表于 Computer Decisions 的“No More Teacher’s Dirty Looks”中正式提出),2026 年访问。 en.wikipedia.org/wiki/Stretchtext ↩
- 29
胡翌霖:《“刷”时代的我们还要“读”吗》,随轩(yilinhut.net),2023 年 4 月 21 日。 yilinhut.net/2023/04/21/9193.html ↩
- 30
Bret Victor:“Explorable Explanations”,2011 年 3 月 10 日。 worrydream.com/ExplorableExplanations/ ↩
- 31
Distill:Archive(首篇文章发表于 2016 年 9 月 8 日),2026 年访问。 distill.pub/archive/ ↩
- 32
Shan Carter & Chris Olah:“Distill: Supporting Clarity in Machine Learning”,Google Research Blog,2017 年 3 月 20 日。 research.google/blog/distill-supporting-clarity-in-machine-le… ↩
- 33
Chris Olah & Shan Carter:“Research Debt”,Distill,2017。 distill.pub/2017/research-debt/ ↩↩2
- 34
Distill Editorial Team:“Distill Hiatus”,Distill,2021 年 7 月 2 日。 distill.pub/2021/distill-hiatus/ ↩↩2
- 35
Springer:Living Reviews in Relativity 期刊主页,2026 年访问。 link.springer.com/journal/41114 ↩
- 36
Max-Planck-Gesellschaft:“In some respects, the Wikipedia of science”(对 Bernard Schutz 的访谈),2013 年 11 月 16 日。 mpg.de/7617181/in-some-respects-the-wikipedia-of-science ↩
- 37
Living Reviews in Relativity:“Update Guidelines”(EMIS 镜像),2026 年访问。 emis.univie.ac.at/journals/LRG/author-information/update-guid… ↩↩2
- 38
Julian H. Elliott et al.:“Living Systematic Reviews: An Emerging Opportunity to Narrow the Evidence-Practice Gap”,PLOS Medicine 11(2): e1001603,2014。 doi.org/10.1371/journal.pmed.1001603 ↩
- 39
Gravitational Wave Open Science Center(原 LIGO Open Science Center):GW150914 信号处理教程(IPython 笔记本与 Python 脚本),2017 年 7 月最后更新。 gwosc.org/s/events/GW150914/GW150914_tutorial.html ↩
- 40
James Somers:“The Scientific Paper Is Obsolete: Here’s What’s Next”,The Atlantic,2018 年 4 月 5 日。 theatlantic.com/science/archive/2018/04/the-scientific-paper-… ↩
- 41
eLife:“eLife launches Executable Research Articles for publishing computationally reproducible results”,2020 年 8 月 24 日。 elifesciences.org/for-the-press/eb096af1/elife-launches-execu… ↩
- 42
Christopher Erdmann, Shelley Stall, Brooks Hanson et al.:“Notebooks Now! Elevating Computational Notebooks”,Eos,2022 年 8 月 18 日。 eos.org/editors-vox/notebooks-now-elevating-computational-not… ↩
- 43
Paul Groth, Andrew Gibson & Jan Velterop:“The anatomy of a nanopublication”,Information Services & Use 30(1–2): 51–56,2010。 doi.org/10.3233/ISU-2010-0613 ↩↩2
- 44
TIB – Leibniz Information Centre for Science and Technology:“About the ORKG”,Open Research Knowledge Graph,2026 年访问。 orkg.org/about ↩
- 45
Terence Tao:“Formalizing the proof of PFR in Lean4 using Blueprint: a short tour”,What’s new(博客),2023 年 11 月 18 日。 terrytao.wordpress.com/2023/11/18/formalizing-the-proof-of-pf… ↩↩2
- 46
Terence Tao:“A pilot project in universal algebra to explore new ways to collaborate and use machine assistance?”,What’s new(博客),2024 年 9 月 25 日。 terrytao.wordpress.com/2024/09/25/a-pilot-project-in-universa… ↩
- 47
Matthew Bolan, Joachim Breitner, Jose Brox et al.(含 Terence Tao):“The Equational Theories Project: Advancing Collaborative Mathematical Research at Scale”,arXiv:2512.07087,2025。 arxiv.org/abs/2512.07087 ↩
- 48
Wikimedia Foundation:“How crawlers impact the operations of the Wikimedia projects”,Diff,2025 年 4 月 1 日。 diff.wikimedia.org/2025/04/01/how-crawlers-impact-the-operati… ↩
- 49
Anthony Ha:“Wikipedia says traffic is falling due to AI search summaries and social video”,TechCrunch,2025 年 10 月 18 日。 techcrunch.com/2025/10/18/wikipedia-says-traffic-is-falling-d… ↩
- 50
João Tomé:“The crawl-to-click gap: Cloudflare data on AI bots, training, and referrals”,Cloudflare Blog,2025 年 8 月 29 日。 blog.cloudflare.com/crawlers-click-ai-bots-training/ ↩
- 51
Ludovico Mitchener et al.:“Kosmos: An AI Scientist for Autonomous Discovery”,arXiv:2511.02824,2025。 arxiv.org/abs/2511.02824 ↩↩2
- 52
Google Search Central Blog:“Introducing schema.org: Search engines come together for a richer web”,2011 年 6 月 2 日。 developers.google.com/search/blog/2011/06/introducing-schemao… ↩
- 53
Google Scholar:“Inclusion Guidelines for Webmasters”,2026 年访问。 scholar.google.com/intl/en/scholar/inclusion.html ↩
- 54
Jeremy Howard:“The /llms.txt file”,llmstxt.org,2024 年 9 月 3 日提出。 llmstxt.org/ ↩
- 55
Roger Montti:“Google Says LLMs.Txt Comparable To Keywords Meta Tag”,Search Engine Journal,2025 年 4 月 17 日。 searchenginejournal.com/google-says-llms-txt-comparable-to-ke… ↩
- 56
Malte Ostendorff:“A Content Analysis of llms.txt Files from the July 2026 Crawl Archive”,Common Crawl Blog,2026 年 8 月 31 日。 commoncrawl.org/blog/a-content-analysis-of-llms-txt-files-fro… ↩
- 57
RenaSci:llms.txt(机器访问说明:schema.org ScholarlyArticle JSON-LD、?format=md、REST API、CC BY 4.0),2026 年 9 月 30 日访问。 renasci.xyz/llms.txt ↩
- 58
Steven Shapin & Simon Schaffer:《Leviathan and the Air-Pump: Hobbes, Boyle, and the Experimental Life》,Princeton University Press,1985。 press.princeton.edu/books/paperback/9780691178165/leviathan-a… ↩
- 59
Zenodo:“About Zenodo”(2013 年 5 月由 CERN 与 OpenAIRE 推出),2026 年访问。 about.zenodo.org/ ↩
- 60
Zenodo:“What is DOI versioning?”,Zenodo 帮助中心,2026 年访问。 support.zenodo.org/help/en-gb/1-upload-deposit/97-what-is-doi… ↩
- 61
Leiden Declaration on Artificial Intelligence and Mathematics,2026 年 6 月 2 日,doi:10.5281/zenodo.20302944。 leidendeclaration.ai/ ↩↩2
- 62
Software Heritage:“Mission”,2026 年访问。 softwareheritage.org/mission/ ↩
- 63
Software Heritage Archive:统计计数接口,2026 年 9 月 30 日读取(约 299.8 亿个文件内容、61.7 亿次提交、4.45 亿个来源项目)。 archive.softwareheritage.org/api/1/stat/counters/ ↩
- 64
Internet Archive Blogs:“One Trillion Web Pages Archived: Internet Archive Celebrates a Civilization-Scale Milestone”,2025 年 10 月 31 日。 blog.archive.org/2025/10/31/one-trillion-web-pages-archived-i… ↩
- 65
Herbert Van de Sompel, Michael L. Nelson & Robert Sanderson:“HTTP Framework for Time-Based Access to Resource States — Memento”,RFC 7089,IETF,2013 年 12 月。 rfc-editor.org/rfc/rfc7089 ↩
- 66
Robust Links:“About”,2026 年访问。 robustlinks.mementoweb.org/about/ ↩
- 67
The Stacks project:“About”(2005 年 7 月 5 日萌生构想,2008 年 5 月 20 日首次提交,维护者 Aise Johan de Jong),2026 年访问。 stacks.math.columbia.edu/about ↩
- 68
The Stacks project:“Tags explained”,2026 年访问。 stacks.math.columbia.edu/tags ↩
- 69
The Stacks project:“Statistics”,2026 年 9 月 30 日访问(共 21446 个标签)。 stacks.math.columbia.edu/statistics ↩
- 70
Pieter Belmans:“A new website for the Stacks project: the sequel”,2013 年 7 月 30 日。 pbelmans.ncag.info/blog/2013/07/30/a-new-website-for-the-stac… ↩
- 71
SWHID Specification v1.0:“Qualified identifiers”(lines 限定符),2026 年访问。 swhid.org/specification/v1.0/6_Qualified_identifiers/ ↩
- 72
- 73
Nature 社论:“Tools such as ChatGPT threaten transparent science; here are our ground rules for their use”,Nature,2023 年 1 月 24 日。 nature.com/articles/d41586-023-00191-1 ↩
- 74
Peter Scholze:“Liquid tensor experiment”,Xena Project 博客,2020 年 12 月 5 日。 xenaproject.wordpress.com/2020/12/05/liquid-tensor-experiment/ ↩
- 75
Mathlib community:“Completion of the Liquid Tensor Experiment”,Lean community blog,2022 年 7 月 15 日。 leanprover-community.github.io/blog/posts/lte-final/ ↩
- 76
Online Etymology Dictionary:“curator”,2026 年访问。 etymonline.com/word/curator ↩
- 77
Timothy Gowers:“Discrete Analysis — an arXiv overlay journal”,Gowers’s Weblog,2015 年 9 月 10 日。 gowers.wordpress.com/2015/09/10/discrete-analysis-an-arxiv-ov… ↩
- 78
NISO:“ANSI/NISO Z39.104-2022, CRediT, Contributor Roles Taxonomy”,2022。 niso.org/publications/z39104-2022-credit ↩
- 79
胡翌霖:《搜集世间一切书籍——AI时代的亚历山大图书馆能长存吗?》,随轩(yilinhut.net),2026 年 4 月 23 日。 yilinhut.net/2026/04/23/10023.html ↩
- 80
胡翌霖:《AI会重构科学史吗》,随轩(yilinhut.net),2026 年 3 月 24 日。 yilinhut.net/2026/03/24/10005.html ↩
- 81
Herbert A. Simon:“Designing Organizations for an Information-Rich World”,载 Martin Greenberger(编)《Computers, Communications, and the Public Interest》,Johns Hopkins Press,1971,第 37–72 页,引文在第 40–41 页;另见 Anastasia Kozyreva, Stephan Lewandowsky & Ralph Hertwig:“Citizens Versus the Internet: Confronting Digital Challenges With Cognitive Tools”,Psychological Science in the Public Interest 21(3): 103–156,2020(引同一句,注明页码)。 doi.org/10.1177/1529100620946707 ↩
- 82
胡翌霖:《按乐分配:人工智能时代如何打破内卷的逻辑》,随轩(yilinhut.net),2026 年 3 月 30 日。 yilinhut.net/2026/03/30/10018.html ↩
- 83
胡翌霖:《什么是技术》,湖南科学技术出版社,2020。 ↩
- 84
João Felipe Pimentel, Leonardo Murta, Vanessa Braganholo & Juliana Freire:“A Large-Scale Study About Quality and Reproducibility of Jupyter Notebooks”,2019 IEEE/ACM 16th International Conference on Mining Software Repositories (MSR),pp. 507–517,2019。 doi.org/10.1109/MSR.2019.00077 ↩
- 85
胡翌霖:《学者如果不用AI,属于学术腐败》,随轩(yilinhut.net),2026 年 5 月 9 日。 yilinhut.net/2026/05/09/10040.html ↩
◇在问题网络中的位置
这个论题向别处问出 14 个问题,别处有 16 个问题问到这里;深读正文里另有 31 处牵连通向别的论题,21 处从别的深读指向这里。每一处都可以点回原来的上下文。